Локальная языковая модель: что остаётся на вашем сервере
Локальный запуск даёт контроль над вычислениями и хранением моделей, но требует настройки самого приложения.
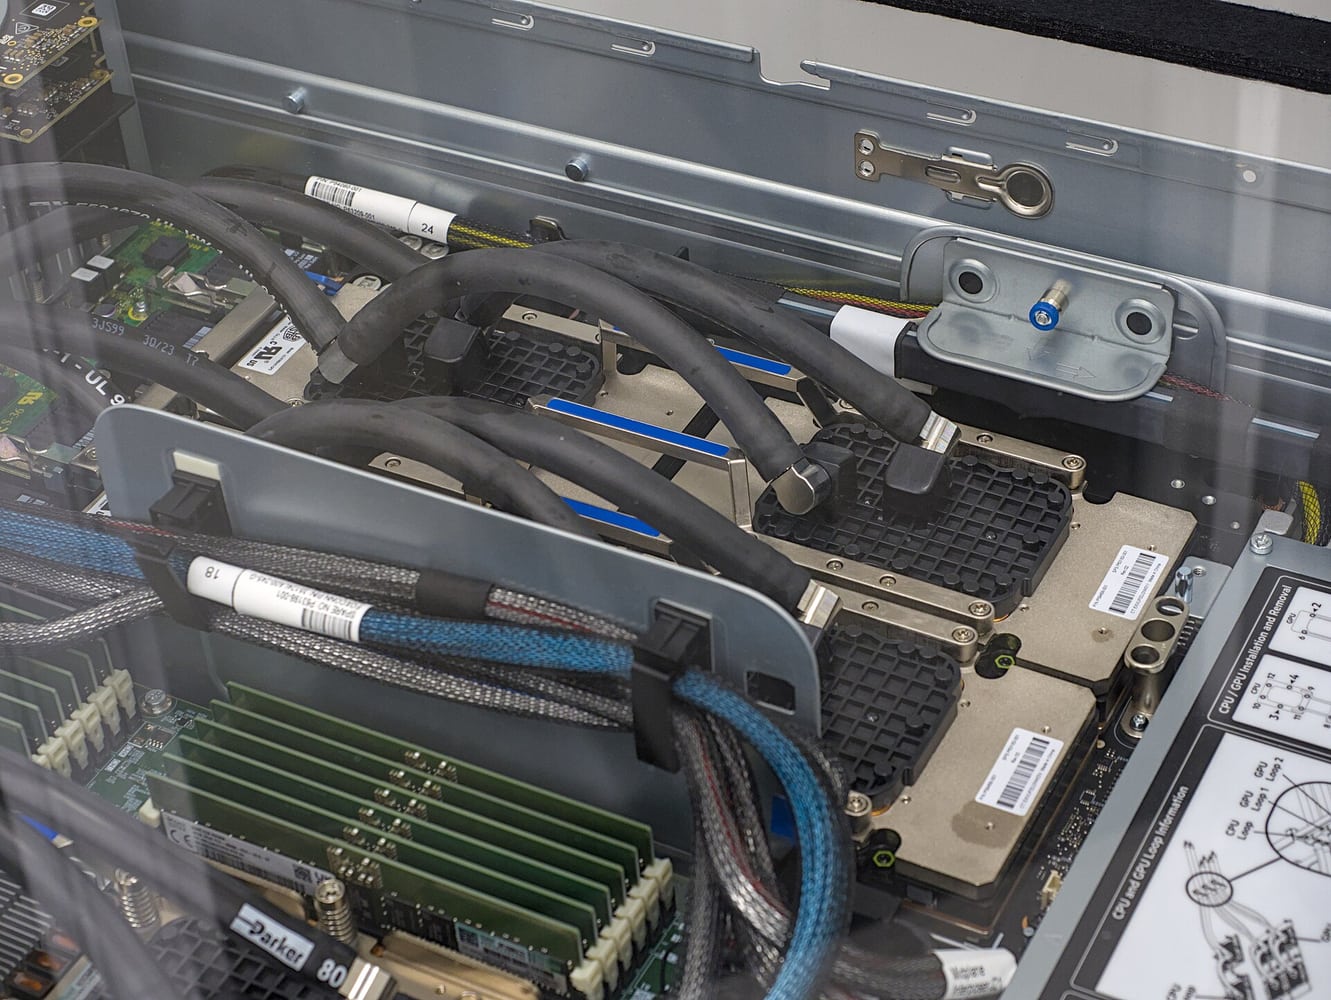
Ollama позволяет выполнять поддерживаемые модели на собственной машине. Для приложения это отдельный сервис: оно отправляет запрос и получает ответ. Серверу нужны память под веса, рабочий контекст и ресурсы для вычислений. Достаточность оборудования проверяют на конкретной модели и длине запроса, а не по одному размеру файла.
Локальность модели и конфиденциальность всей системы — разные задачи. Источники, плагины и внешние инструменты могут обращаться в сеть независимо от неё. Практический первый шаг — описать путь данных: от формы пользователя до журналов и резервных копий. Это помогает понять, какие части действительно работают внутри вашей инфраструктуры.